来源 :快科技2026-08-27
快科技8月27日消息,8月26日晚,智谱正式上线并开源GLM-5.3-Flash(320B-A18B)原生多模态模型。摩尔线程在模型发布当天便完成Day-0极速适配,基于AI训推一体智算卡MTT S5000及MUSA软件栈实现高效运行。
GLM-5.3-Flash总参数量320B(3200亿),激活参数仅18B(180亿),层数较GLM-4.5减半。模型在全球权威的Artificial Analysis Intelligence Index中取得57分;在智谱自研Z.ai Code Bench体感评估中,其编程表现与Claude Opus 4.8相当。
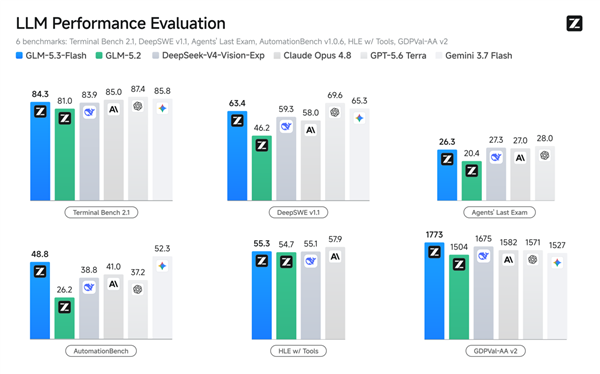
正式发布前,该模型以匿名代号Ox-Alpha(中文社区昵称“牛来”)在OpenRouter、OpenCode两大海外平台测试,迅速登顶并刷新双平台历史纪录,Token调用量高达62T。
如此高的Token调用量,出自超过10万张国产芯片的集体承载,其算力供应商包括华为、海光、摩尔线程。这是国产算力芯片首次大规模集体出海支持海外最火模型。
针对GLM-5.3-Flash混合架构中线性注意力采用的KDA机制,摩尔线程基于MATE算子优化引擎,快速完成了状态矩阵更新、分块并行扫描等全新算子形态的定制实现与深度调优。
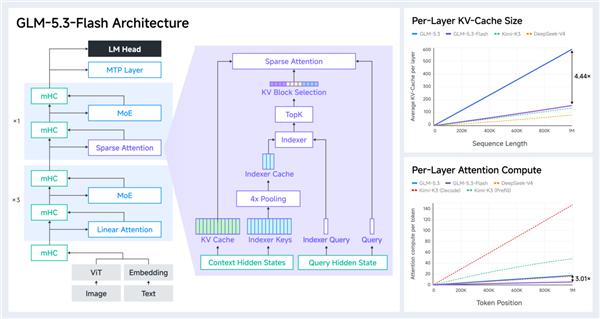
KDA机制将传统注意力中随推理长度线性增长的KV Cache转化为固定规模状态矩阵的增量更新,显存占用不再随序列变长而膨胀。该架构特性与MTT S5000的高算力密度形成深度协同,为超长上下文推理提供高效支撑。
本次极速适配充分验证了MTT S5000智算卡的高算力密度与稳定性。MTT S5000单卡FP8算力达1000 TFLOPS,配备80GB显存,显存带宽1.6TB/s,卡间互联带宽784GB/s。
目前智谱GLM-5.3-Flash已开源,开发者可访问Hugging Face获取模型权重,摩尔线程也提供了配套的SGLang推理镜像供开发者开箱体验。
【本文结束】如需转载请务必注明出处:快科技
责任编辑:红茶
文章内容举报