当整个行业还在讨论 Prompt 注入与模型越狱时,真正的风险正潜伏在更底层。一次精心构造的 HTTP 请求,可能让整套 AI 服务瞬间瘫痪。
vLLM、Ollama、llama.cpp、TensorRT-LLM、SGLang——这些支撑智能客服、代码助手、企业 Agent 的 LLM 推理引擎,通过 OpenAI 兼容 API 对外暴露服务。一旦底层被击穿,影响将直接传导到上层应用。
在 XCon2026 安全焦点信息安全技术峰会上,绿盟科技天元实验室高级安全研究员顾佳伟与天机实验室高级安全研究员周振带来议题《一触即溃:AI赋能的LLM推理引擎模糊测试及基础设施漏洞挖掘》,系统展示了绿盟科技在 AI 基础设施安全领域的最新研究成果。
七层攻击面:从 HTTP 到 GPU 的信任穿透
研究团队将推理引擎拆解为从 HTTP 接口到 GPU 执行的一连串处理层级。核心发现是:输入校验几乎都堆在最外层,越往下游、校验越稀疏,畸形输入可以一路穿透到 C++/CUDA 层,触发不可恢复的崩溃。
其中最具代表性的,是控制 Token 注入:在默认配置下,用户输入里的一些特殊符号会被当成控制指令执行——本质上是控制面与数据面混淆,和二十年前的 SQL 注入属于同一类架构缺陷。这条思路还能跨模态、跨引擎复用,影响范围远大于单个组件。
LLM Fuzzer:把 AI 变成漏洞挖掘的放大器
传统模糊测试工具在 LLM 推理引擎上基本失效——既拼不出合法请求,也分不清「真崩溃」和「正常报错」。
研究团队打造了一套 AI 驱动的模糊测试体系,重点突破了三个难题:精准识别目标引擎与攻击面、在通过层层格式校验的同时送达恶意载荷、以及在海量响应中准确区分崩溃与噪音。这让原本难以触及的推理引擎漏洞,变成可被系统化、自动化发现的问题。
实战战果:一次 POST 请求,推理服务彻底宕机
在 Ollama、llama.cpp、vLLM 等主流引擎中,研究团队已挖掘出 8 类高危问题,涵盖图像解码器校验不足、采样器参数越界、多模态内存访问越界、信息泄露与日志伪造等。
这些漏洞的共性是:无需复杂攻击链,仅一次 POST 请求即可导致服务宕机。这对依赖 LLM API 提供商及企业私有部署的架构师而言,具有很强的现实预警意义。
Agentic Research:AI 正在重塑漏洞研究范式
研究团队把 AI 智能体引入漏洞研究全流程,形成「攻击面发掘→自动化测试→漏洞验证→报告披露」的自驱闭环,并配套了一套工程化的质量控制机制,确保发现的高危漏洞稳定可复现、避免误报。
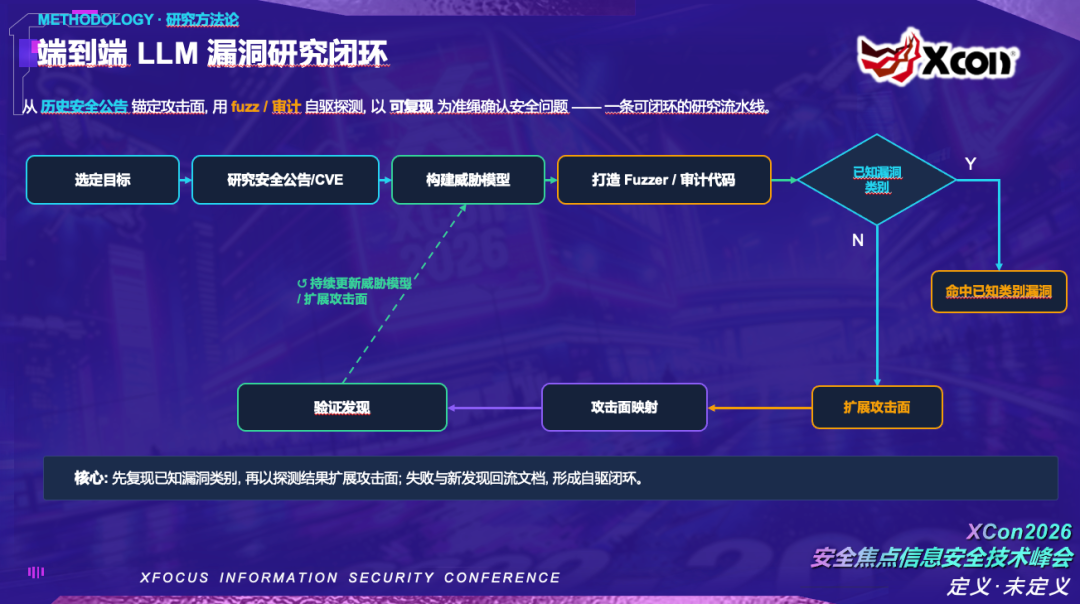
覆盖优先、严谨优先。误报是最大的敌人。
绿盟观点:AI Infra 安全正在成为独立赛道
研究团队对 AI 基础设施安全的未来给出五点判断:
AI Infra 安全成为独立赛道——推理引擎、GPU 集群、模型服务网关将形成专门研究领域。
以模制模成为主流方法论——用 AI 模型解决 AI 模型的安全问题。
AI 红队与智能体攻防重塑对抗模式——从「人工驱动 AI 工具」演进为「AI 智能体自主执行攻防任务」。
AI 对漏洞研究产生结构性冲击——从专家经验驱动转向 AI 规模化驱动。
攻防边界动态演进——AI Infra 安全将形成攻防双方持续博弈、相互促进的格局。
绿盟AI安全能力:让「以模制模」从研究走向实战
绿盟科技长期深耕 AI 安全与智能攻防研究。天机实验室聚焦漏洞挖掘、漏洞分析、漏洞利用与防御对抗;天元实验室聚焦 AI 红队、智能体安全、威胁狩猎与实战化攻防,已发布国内首个大模型智链安全社区 AISS。
从此次 XCon2026 议题可以看到,绿盟科技正在把「以模制模」从理念变成可工程化的能力:
AI 赋能漏洞挖掘:通过智能化研究与自动化测试,实现攻击面自动发现、载荷智能构造、崩溃精准判定。
AI 基础设施安全评估:面向 LLM 推理引擎、模型服务、GPU 集群,提供系统化安全测试与风险排查。
大模型安全红队:覆盖模型层、Agent 层、基础设施层的全栈 AI 安全评估与实战化攻防演练。
AI 安全不能只停留在应用层。把防护边界从 Prompt 下移到推理引擎、从单点漏洞扩展到系统架构,是企业级 AI 部署必须补上的关键一课。绿盟科技愿与各行业客户一起,用 AI 锻造更安全的 AI 底座。