来源 :卫宁健康2026-10-10
NEWS
2026 年 9 月,第十六届东方放射学学术会议(OCR 2026)暨华东六省一市放射学分会年会在上海举行。卫宁健康与上海市第十人民医院(同济大学附属第十人民医院)的合作研究在会上亮相。
双方合作论文题为《Domain-Specific Vision-Language Model for Whole-Body Musculoskeletal Radiograph Interpretation》,以英文口头报告形式登台汇报,系统展示了联合研发的领域专用视觉语言模型MSKVLM,介绍其在全身骨肌影像解读中的整体思路与多中心验证结果。
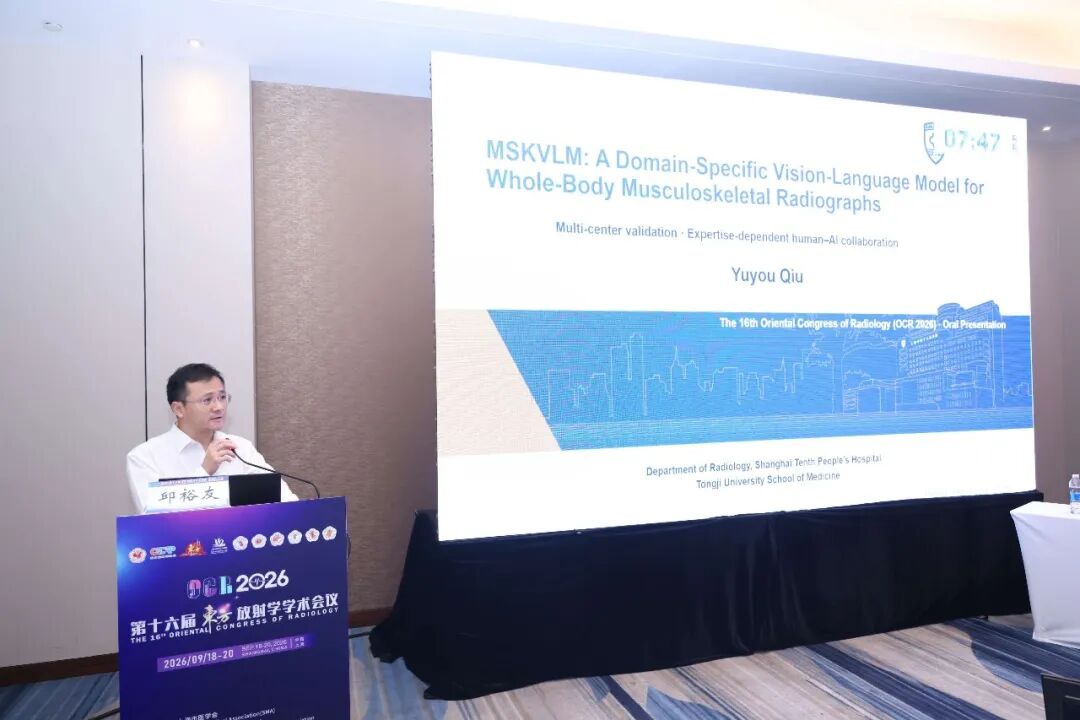
同济大学附属第十人民医院放射科邱裕友主任
老问题
骨肌X线量大,却长期缺少统一“写法”
骨肌X线是放射科里数量最大的检查之一,却长期缺少统一、规范的诊断标签。同一张影像,不同医生、不同医院的报告描述五花八门,质控难以落地,数据也很难规模化利用。而通用视觉语言模型到了这种细粒度场景,往往“看得见,却说不准”。
写法不统一,根源在于“认部位”和“出诊断”这两步长期各自为战:部位命名没有统一口径,诊断结论也缺少标准标签。领域专用视觉语言模型MSKVLM要做的,正是把这条链路真正打通。
新方法
领域专用模型,一个模型同时做三件事
团队为骨肌影像专门训练了一个领域专用的视觉语言模型:先在多来源的医学图文数据上继续预训练,再用16年、五家三级医院的真实临床数据做结构化微调。由此,一个模型便能同时承担三件事——认出是哪个部位、检出骨关节各类疾病、直接生成诊断标签。而这样的设计也换来了实实在在的表现:它追平甚至超过了过去“一个任务训一个模型”的专用模型,并在多中心真实数据上明显优于多个通用大模型。临床专家逐例阅片核验后给出的结果是:解剖部位准确率 98.0%,异常分类 83.6%,诊断结论准确率 81.5%。
三张图看懂这项研究
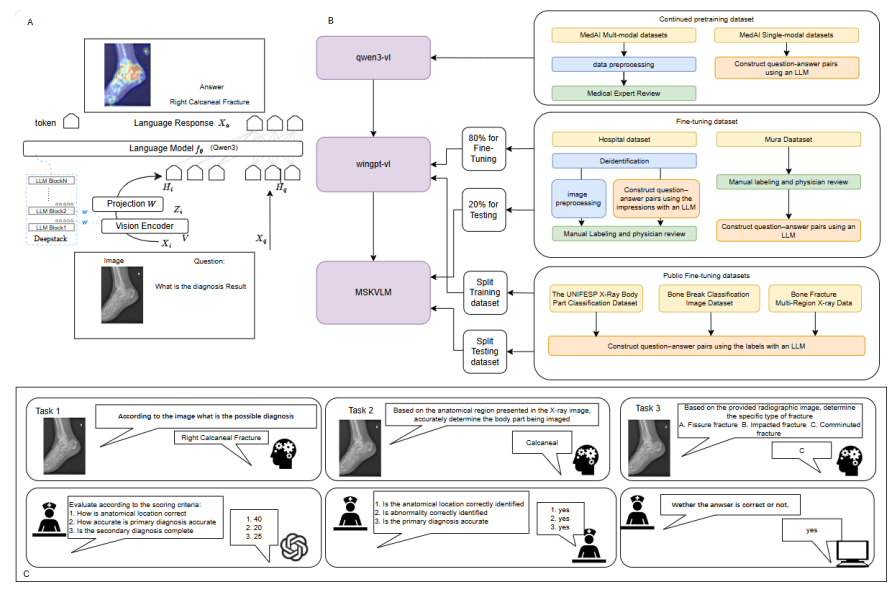
整体流程图示
这项研究的整体设计可以分为三步:
A,Qwen3-VL 接收 X 光片和结构化问题,通过多模态推理给出诊断结果;
B,训练数据先由 LLM 从影像报告中生成问答对,再由医师审核精修,公开的骨肌 X 线数据集也经过同样的问答对构建,最终用于模型训练;
C,模型下游要完成主诊断生成、解剖部位识别和数据集特定分类,每项任务都有各自的评分标准。
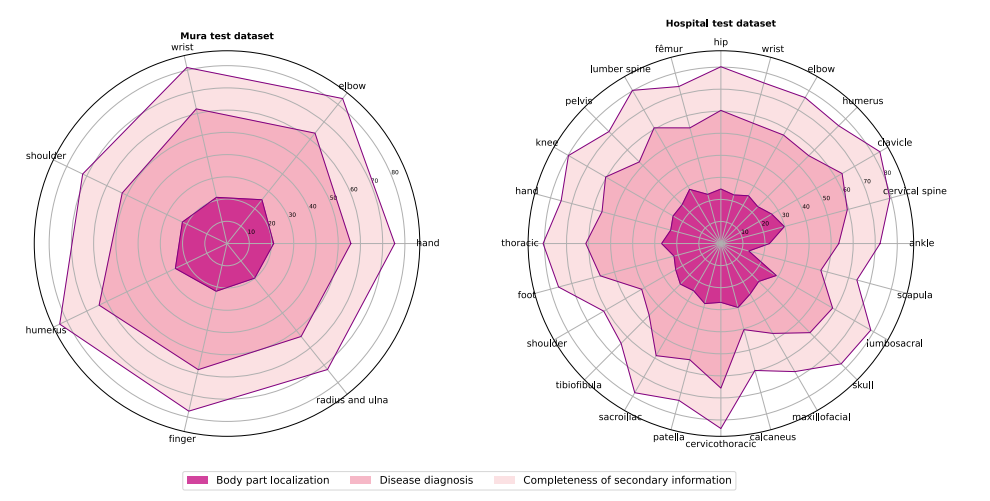
三维评分图示
在 MURA 测试集(左,7 个部位)与医院测试集(右)上,模型会按解剖部位分别打分,评分维度有三个——部位定位、疾病诊断、次要信息完整性。其中,医院测试集覆盖的解剖区域更广,从四肢长骨到脊柱各段,再到颅骨、颌面,都在其中。
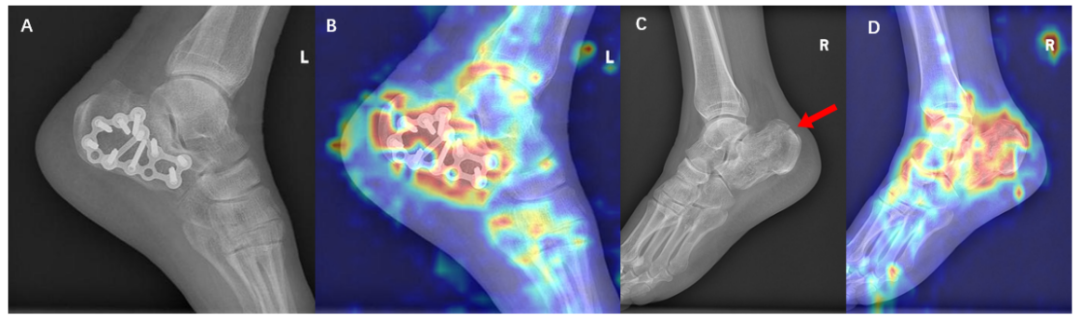
可解释性图示
左侧为跟骨骨折内固定术后(A / B),右侧为跟骨骨折(C 中红箭所指,D 为对应热力图)。可以看到,模型的注意力始终集中在病变本身,而不是分散到整张影像上。
人机协同
AI给初级医生带来了更大的帮助
本研究进行了多阅片者、多病例交叉研究并给出了答案:AI 的辅助效果随年资分化,和医生的年资高低密切相关,两者之间的交互作用显著(Wald χ2(2)= 18.34,p < 0.001)。其中,初级医师受益最稳定。
初级医生组中,有了AI辅助,他们的阅片准确率提升了 4.88 个百分点(p=0.017),而且在 6 个数据集上结果一致。这说明 AI 和医生之间形成了互补,正好补在年轻医生相对薄弱的地方。在基层医院或资源有限、以年轻医生为主的场景里,AI 更像一台“诊断能力补齐器”:帮他们缩小与高年资医生之间的差距,把原本只有专家才能提供的支持,延伸到这些原本覆盖不到的人群。
从“认部位”到“出诊断”,MSKVLM 在 OCR2026 上展示的,不只是一个模型的能力,更是一条从影像数据通向临床决策的可行路径。对卫宁健康而言,这也是与上海市第十人民医院合作取得的一项阶段性成果。未来,双方将继续围绕骨肌影像乃至更广泛的医学影像场景深入探索,让 AI 真正走进日常阅片,融入临床决策的关键环节。