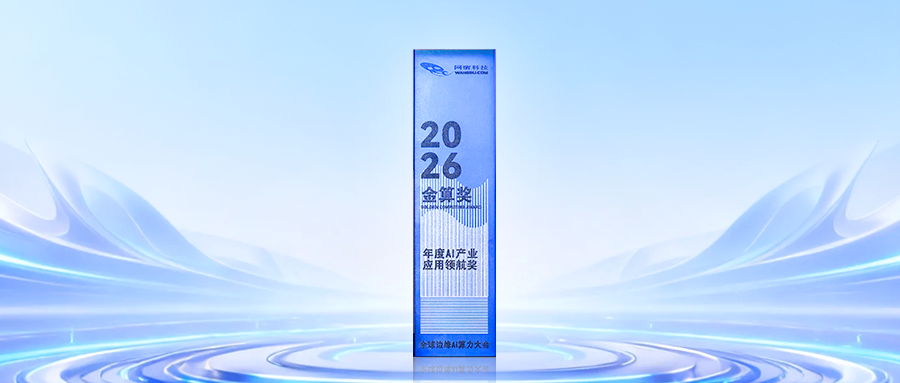
9月11日,全球边缘AI算力大会在北京召开。会上,网宿科技凭借在边缘AI领域的持续布局与实践,斩获金算奖·年度AI产业应用领航奖。
同时,网宿科技边缘AI资深架构师陈云辉在会上分享了网宿从“流量管道”到“分发智能”的演进路径、能力体系以及未来展望。
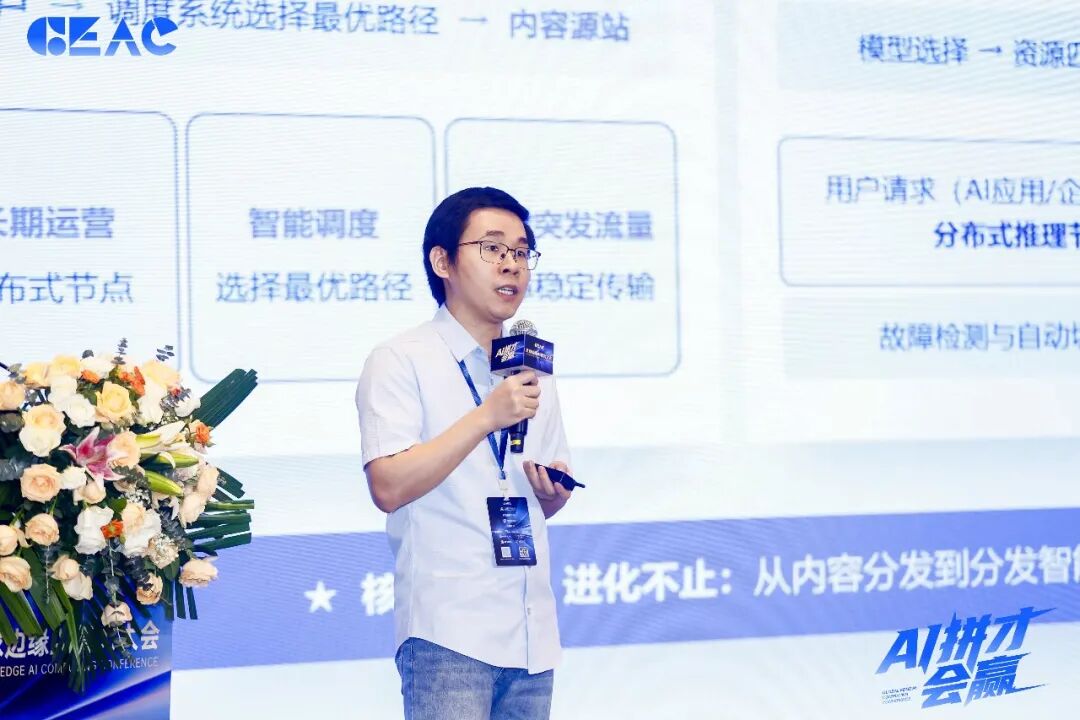
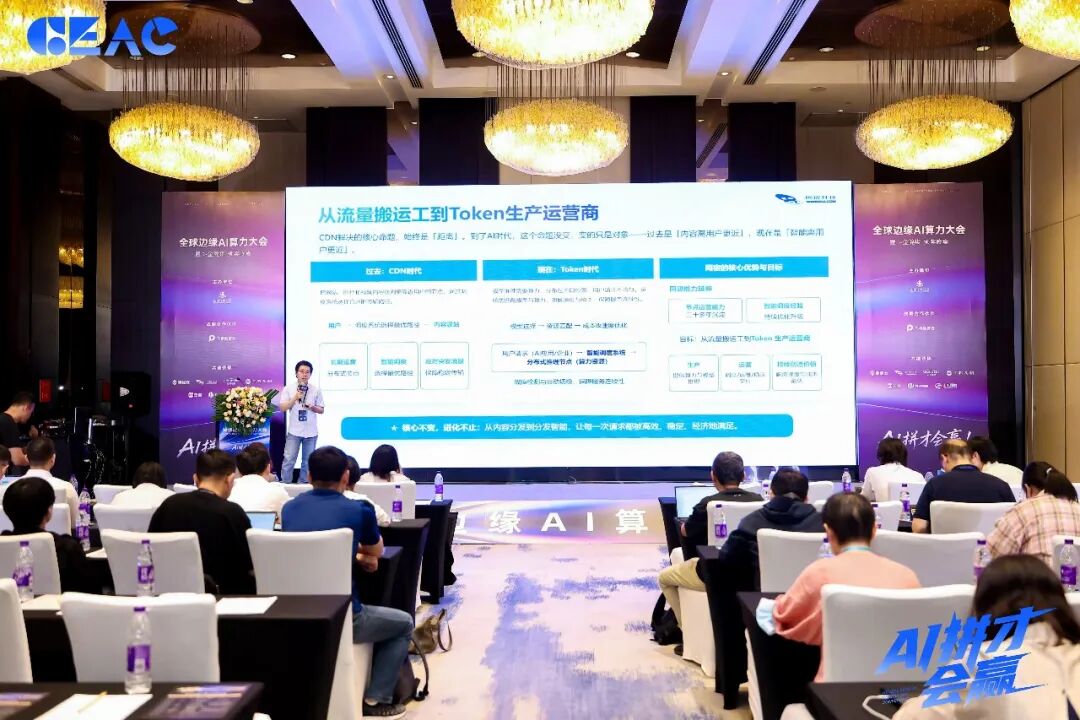
能力同源:从分发内容到分发智能
机器流量正在超过人类访问流量,一次业务请求的背后不再是打开一个网页,而是调用模型、生成Token、协同多个Agent,而网络要解决的核心问题始终未变——过去是让内容离用户更近,现在是让智能离用户更近。
陈云辉指出,CDN时代,网宿把网站、图片、视频等内容送到靠近用户的边缘节点,通过智能调度系统选择最优传输路径,应对突发流量,保障稳定传输。进入Token时代,模型推理需要算力,而算力分布在不同位置,用户请求也存在明显波峰波谷,系统不仅要完成模型与算力的资源匹配,还要在速度、成本和服务稳定性之间取得平衡,并通过故障检测、自动切换等机制保障服务连续性。
这些,正是网宿科技长期积累的核心能力。
依托二十多年边缘节点运营经验、智能调度能力以及全链路安全防护体系,网宿科技正在将服务对象从“内容”拓展到“智能”,从“传输内容”走向“分发智能”。
边缘AI网关:以统一入口,运营智能
“网宿的目标是通过生产侧和运营侧的持续优化,让每一次用户请求都被高效、稳定、经济地满足。”陈云辉表示。
网宿将边缘AI网关定位为企业AI化的统一入口,企业通过边缘AI网关即可接入200多个模型,并按需调用模型、启用安全能力、配置智能调度策略与缓存策略。
围绕这一统一入口,网宿重点构建了三类能力。
01
智能路由(Auto)与多模型融合(Fusion)
Auto根据任务复杂度、成本约束与实时负载,自动匹配模型,实现成本与质量的动态平衡。
Fusion则在网关层实现多模型并发、独立推理与结果共识提炼,将多个模型的能力进行组合,提升最终输出的稳定性与可靠性,同时降低企业自建多Agent系统的开发与运维负担。
02
分层调度与闲时复用
边缘节点承接轻量实时推理,区域GPU承接中等任务,中心集群承接复杂批量推理;叠加跨时区、跨客户、跨业务的错峰调度,让算力潮汐被运营起来,而非被闲置或堆高成本,充分释放算力价值。
03
安全防护与统一治理
在安全层面,网宿构建“入口防护+网关管控+AI防爬+持续安全运营”的边缘AI安全闭环。在治理层面,则通过统一AI治理(UAG)管好成本账、安全账、责任账,让AI成为可控、可靠、可持续的生产力。
Token工厂:让算力成为可运营的产能
在江苏常州与浙江海宁,网宿联合产业链伙伴共建城市级绿色Token工厂,探索形成绿色化、标准化的Token服务能力。
与此同时,网宿还在探索推理引擎优化、算力闲时复用机制,进一步提升资源利用率和推理效率。
“通过生产、调度与优化环节的自动化闭环,最终形成模型优化推理服务、推理服务承载模型的能力循环。”陈云辉表示。
模型决定下限,调度、成本与安全决定上限
从早期ChatGPT的单轮问答,到如今的Agent、A2A(Agent to Agent)交互,单个任务需要经历多轮模型调用和工具调用。与此同时,AI Coding等赛道已经实现商业化闭环,多模态生成的需求也在快速爆发。
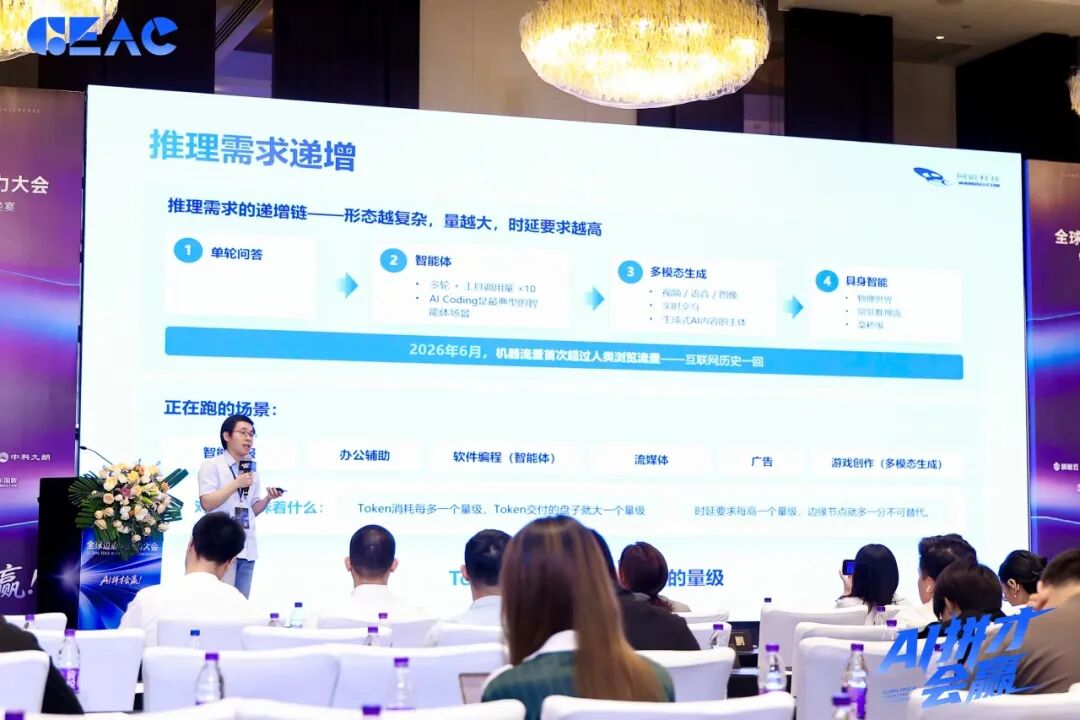
陈云辉表示,Token消耗每增长一个量级,Token交付的市场空间就会进一步扩大;时延要求每提升一个层级,边缘节点的价值也会更加凸显。
其中,AI视频生成尤其值得关注。
相比语言大模型,视频模型的参数规模通常相对较小,更适合在边缘节点运行。同时,视频生成、审核和推流往往需要被压缩到秒级窗口,对就近计算和低时延链路提出了更高要求。
网宿将对H3等开源视频模型进行持续的深度定制优化,将5秒视频的生成时间从28秒压缩至3~4秒,实现“生成速度快于播放速度”,为实时直播等场景提供支撑。
“模型决定生成效果的下限,而能否规模化落地,取决于模型之上的调度能力、成本控制与合规保障,这正是网宿从CDN转型AIDN的核心机遇。”陈云辉表示。